Beaucoup d’entreprises disposent, pour leurs actions commerciales, d’un fichier de prospection de plusieurs centaines ou milliers de lignes à qualifier avant de pouvoir être exploité : éliminer ce qui sort du périmètre visé, répartir les entreprises retenues selon les critères propres à l’offre commerciale, et trouver, pour chacune, l’identité d’une personne à contacter.
Confier cette tâche à une IA générative paraît une solution naturelle. Mais des écueils apparaissent vite, faute d’une méthode pensée en amont.
- Le premier est la fiabilité : une automatisation mal encadrée nécessite de vérifier chaque ligne à la main, ce qui reste long.
- Le second est moins souvent anticipé, et pourtant décisif : le coût, qui engage la faisabilité même de l’opération. Demander à l’IA de mener elle-même chaque recherche et d’analyser les sites web qu’elle trouve lorsqu’elle recherche des informations sur chaque prospect peut consommer un volume de jetons (tokens) disproportionné, au point de rendre la tâche irréalisable à l’échelle d’un fichier de plusieurs milliers de lignes, et pas seulement coûteuse.
C’est ce second écueil que nous avons rencontré concrètement en qualifiant notre propre fichier de prospection commerciale avec Claude Cowork : plus de deux mille entreprises à trier avant identification, pour chacune des entreprises retenues, d’une personne à contacter. Ce qui a suivi a conduit à revoir entièrement la méthode.
Il y a donc deux approches pour qualifier une base de données volumineuse avec l’IA : une approche directe, qui fonctionne mais n’est pas très efficace ni fiable, et une approche en deux étapes beaucoup plus performante.
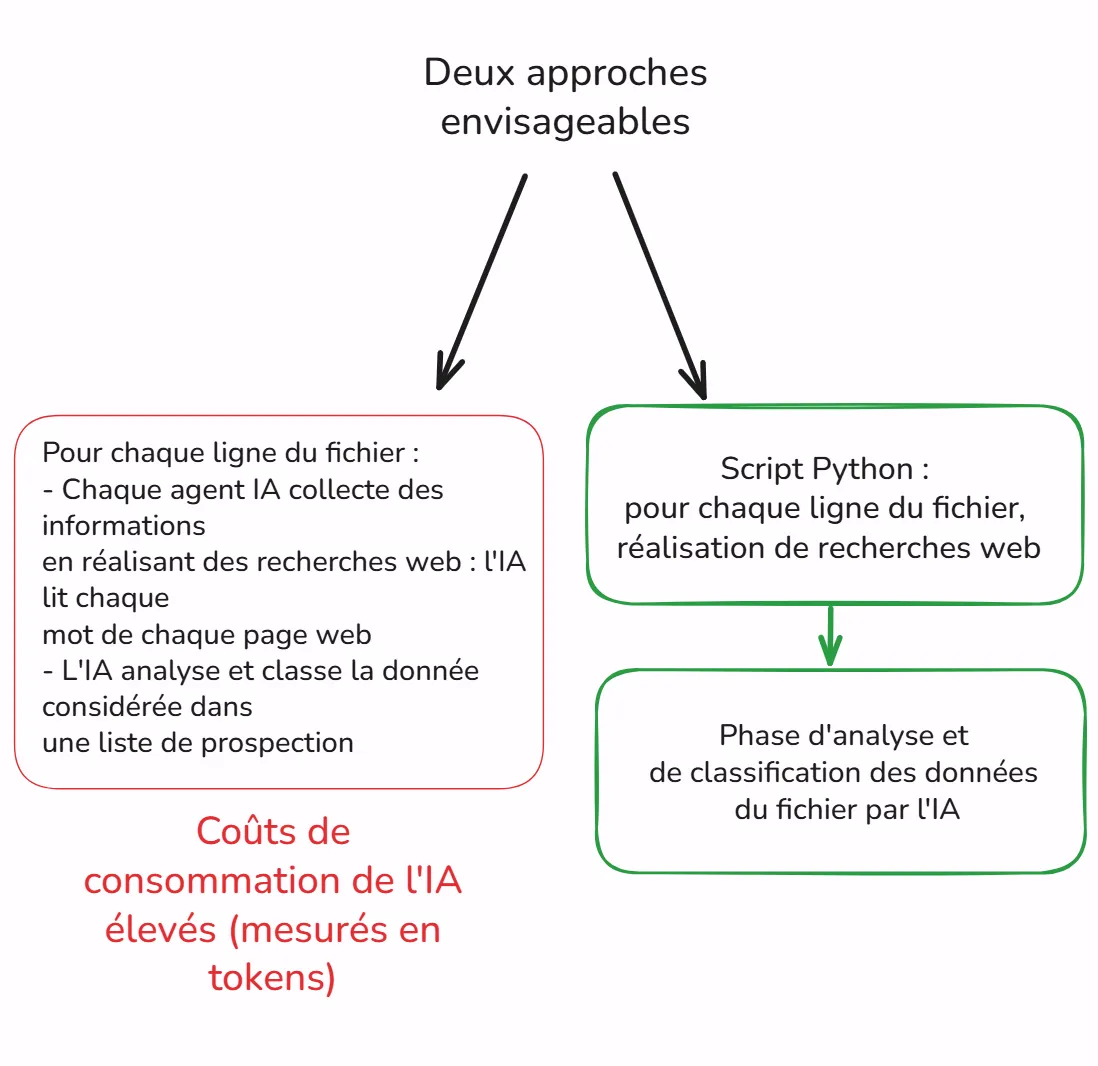 Deux approches pour qualifier une base de données volumineuse avec l’IA
Confier l’ensemble de la recherche à l’IA conduit à une explosion des coûts
La première approche paraît la plus directe : demander à l’IA, via un prompt détaillé, de réaliser l’opération dans son intégralité, depuis la recherche d’informations jusqu’à la répartition des prospects dans des listes de prospection selon les critères qu’on lui indique. Pour réaliser cette tâche, l’IA va alors répartir les entreprises de la base entre plusieurs agents IA travaillant en parallèle, chacun chargé d’une partie d’entre elles. Pour chaque entreprise, l’agent IA doit vérifier sa situation (activité, éventuelle procédure collective), puis identifier une personne à contacter en croisant plusieurs recherches web et, parfois, la lecture de pages d’entreprise ou de sites d’information.
Cette méthode, que nous avons testée en utilisant Claude Cowork, permet de traiter un premier lot d’une cinquantaine d’entreprises sur une base de plus de 2000 lignes, mais à un coût élevé. Pour ses dix entreprises, chaque agent a effectué entre 120 et 185 appels d’outils (recherches web, lecture des pages trouvées, consultations du registre des entreprises, écriture de notes) au total et consommé entre 160 000 et 210 000 tokens. Le nombre de recherches web par entreprise était en moyenne de 4. Ainsi, le budget de recherche accordé pour la session, fixé à 200 requêtes web, a été épuisé par ce seul lot de cinquante entreprises, avant même d’avoir couvert un dixième de la base totale. À ce rythme, qualifier l’ensemble du fichier aurait supposé soit de relever artificiellement ce budget, soit de fractionner le travail en plusieurs dizaines de sessions distinctes.
D’autres frictions sont apparues en cours de route : certains sites refusent l’accès aux robots via leur fichier robots.txt, l’API officielle du registre des entreprises consulté a parfois renvoyé des erreurs de limitation de débit, et la lecture de chaque site d’entreprise nécessitait une autorisation d’accès distincte, ce qui interrompait le travail à intervalles réguliers pour demander une validation.
Séparer la collecte et l’analyse : un script Python, puis l’IA
Le constat tiré de ce premier lot était simple : l’essentiel du coût ne venait pas du raisonnement, mais de la collecte brute d’informations, une tâche mécanique que l’IA effectuait pourtant à chaque fois par une succession de recherches et de lectures de pages. La méthode a donc été redécoupée, en confiant la collecte à un programme et l’analyse à l’IA.
1- Collecte de l’information via un script Python
Nous avons donc demandé à l’IA d’écrire un script Python pour automatiser la collecte d’informations. Pour chaque entreprise, il interroge l’API officielle du registre des entreprises (pour connaître la situation administrative par exemple), et, lorsqu’une adresse de site peut être identifiée, il en extrait uniquement les passages contenant des mots-clés liés à l’information désirée (si vous recherchez le contact d’un dirigeant, les mots-clés suivants peuvent être inclus : dirigeant, gérant, président, directeur général, fondateur, et leurs variantes).
Ce script s’est néanmoins heurté à une restriction inattendue : il ne pouvait pas s’exécuter dans l’environnement cloud utilisé pour la conversation avec l’IA de Claude, dont le réseau bloquait l’accès à l’API du registre. Il a en revanche fonctionné sans difficulté une fois lancé directement en local sur notre ordinateur, dont les réglages réseau autorisaient cet accès. Ce script a traité 92 entreprises en quelques minutes, produisant un rapport condensé de quelques dizaines de kilo-octets, soit quelques milliers de jetons pour l’ensemble du lot, là où un lot comparable avait demandé plusieurs centaines de milliers de jetons avec la première méthode.
2- Analyse avec l’IA
L’IA n’a ensuite plus eu besoin de parcourir aucun site : elle a lu un seul document de synthèse produit par le script, réunissant pour chaque entreprise l’état administratif, les dirigeants inscrits au registre, et les extraits pertinents du site le cas échéant. Une vérification ciblée est intervenue à ce stade, sous la forme d’une seule recherche web par entreprise, en s’appuyant uniquement sur les titres et courts extraits renvoyés par l’outil de recherche, sans jamais ouvrir de page. Cette vérification visait à confirmer qu’un dirigeant identifié par le script était toujours en poste, à repérer un signe de procédure collective ou de rachat, et à lever un doute sur le secteur d’activité lorsque le rapport du script ne suffisait pas à trancher. Elle a représenté environ 85 recherches pour 92 entreprises, contre environ quatre recherches par entreprise avec la première méthode.
C’est à cette étape qu’intervient le travail de jugement proprement dit : décider si une entreprise correspond aux critères de la campagne, vers quelle catégorie l’orienter selon son secteur, et si le rôle d’un dirigeant est suffisamment confirmé pour être retenu tel quel ou devait être signalé comme à vérifier. Ce travail restait entièrement du ressort de l’IA ; le script, lui, ne prenait aucune décision, il se contentait de rassembler la matière première.
Une limite cependant : une recherche web sans lecture de page ne fournit que des indices, pas une confirmation certaine. Elle suffit souvent à repérer un changement de situation notable, plus rarement à garantir avec certitude qu’une personne occupe toujours une fonction précise. Il est donc nécessaire de demander à l’IA de le signaler explicitement, plutôt que présenter une certitude qu’elle n’a pas.
| Indicateur | Approche 1 : recherche web ligne à ligne | Approche 2 : script + analyse ciblée |
|---|---|---|
| Nombre de lignes traitées | 50 | 92 |
| Recherches web au total | ~200 | ~95 |
| Estimation du nombre de tokens consommés pour l’ensemble du processus | ~800 000 à 1 050 000 (mesuré : 5 agents × 160 000-210 000) | ~100 000 à 160 000 (estimation) |
| Estimation du nombre de tokens consommés par ligne | ~16 000 à 21 000 | ~1 100 à 1 700 (estimation) |
Une méthode transposable à plusieurs cas d’usages
La méthode détaillée ici n’est pas utile seulement dans le cadre de la prospection commerciale : elle peut être utile pour d’autres cas d’usages. Chaque fois qu’une tâche de qualification de données répète la même collecte sur un grand nombre de lignes, qu’il s’agisse d’un fichier de prospection, d’une base de recrutement, d’un panel d’étude ou d’une mise à jour de CRM, il est presque toujours plus efficace d’écrire un programme pour cette collecte que de la confier directement à l’IA ligne par ligne. Le programme ne coûte rien à chaque exécution, applique la même méthode à chaque ligne, et peut être corrigé une fois pour toutes plutôt que repris à chaque cas. L’IA retrouve alors son rôle propre : interpréter une information déjà rassemblée, arbitrer les cas ambigus, et produire un résultat structuré.
Un second enseignement concerne l’environnement d’exécution, souvent négligé : un script de collecte peut se heurter à des restrictions réseau qui n’existent pas ailleurs, et le bon environnement pour l’exécuter n’est pas toujours celui où se déroule la conversation avec l’IA.
Au final, la fiabilité et le coût d’un projet de qualification de données à grande échelle dépendent moins de la puissance du modèle mobilisé que de la manière dont la tâche est découpée en amont : ce qui relève d’une collecte mécanique d’un côté, ce qui relève d’un jugement de l’autre. C’est cette répartition, plus que le choix d’un outil ou d’un modèle, qui a déterminé si notre propre fichier de prospection restait traitable à l’échelle voulue.