Les développeurs et développeuses qui adoptent l’IA pour le code ont souvent les mêmes questions après quelques semaines d’utilisation :
- Comment réduire ma consommation de tokens avec Claude Code ?
- Comment améliorer la qualité du code généré ?
- Ce nouveau modèle d’IA dernier cri vaut-il son prix ?
- Dois-je adopter cette méthodologie que j’ai vue passer sur LinkedIn ou Twitter ?
- Ai-je vraiment gagné en productivité avec l’IA ?
- Etc.
Chacune de ces questions représente un vrai défi, mais par chance, il y a une technique qui marche à tous les coups : observer et évaluer.
Pourquoi l’observabilité est nécessaire pour tous les agents IA ?
Il faut garder en tête qu’un agent IA pour le code comme Claude Code est d’abord… un agent IA. C’est-à-dire un système qui combine des outils informatiques (accès au débogueur, capacité à lancer des commandes…) et un modèle d’intelligence artificielle de type LLM. On parle aussi de boucle agentique (agent loop).
Or, les LLM n’ont pas un comportement prédictible. Il n’y a pas vraiment de “théorie” du fonctionnement d’un LLM à ce jour. En cherchant à réduire ces coûts, on peut accidentellement réduire la qualité du code obtenu par exemple, parfois de manière subtile et difficile à détecter.
En résumé, pour savoir si une technique d’utilisation de l’IA pour le code fonctionne mieux qu’une autre, il n’y a qu’une seule façon de faire : essayer !
Mais faire des essais dans son coin en quelques minutes ne suffit pas. L’observabilité ou monitoring consiste à systématiser la mesure du comportement d’un agent IA. On garde une trace sur le long terme, et on peut aller jusqu’à mettre en place des expérimentations.
Des outils comme LangSmith ou langfuse sont utilisés par les développeurs agentiques pour monitorer des agents implémentés avec LangChain ou d’autres technologies. Mais trop souvent, les programmeurs oublient que cela s’applique aussi aux agents de code comme Claude Code ou Codex.
Comment monitorer le fonctionnement de Claude Code ?
Trois techniques permettent d’ouvrir le capot de Claude Code et d’observer son comportement.
Technique 1 : avec langfuse
La première consiste à configurer une connexion avec une plateforme de monitoring telle que Langfuse. C’est très simple et bien documenté sur le site de langfuse. Si tout est bien configuré, quelques secondes plus tard, vous verrez s’afficher une “trace”, qui montre le déroulement d’une conversation avec Claude.
Vous pouvez même afficher un graphe représentant les appels d’outils, ici un appel bash.
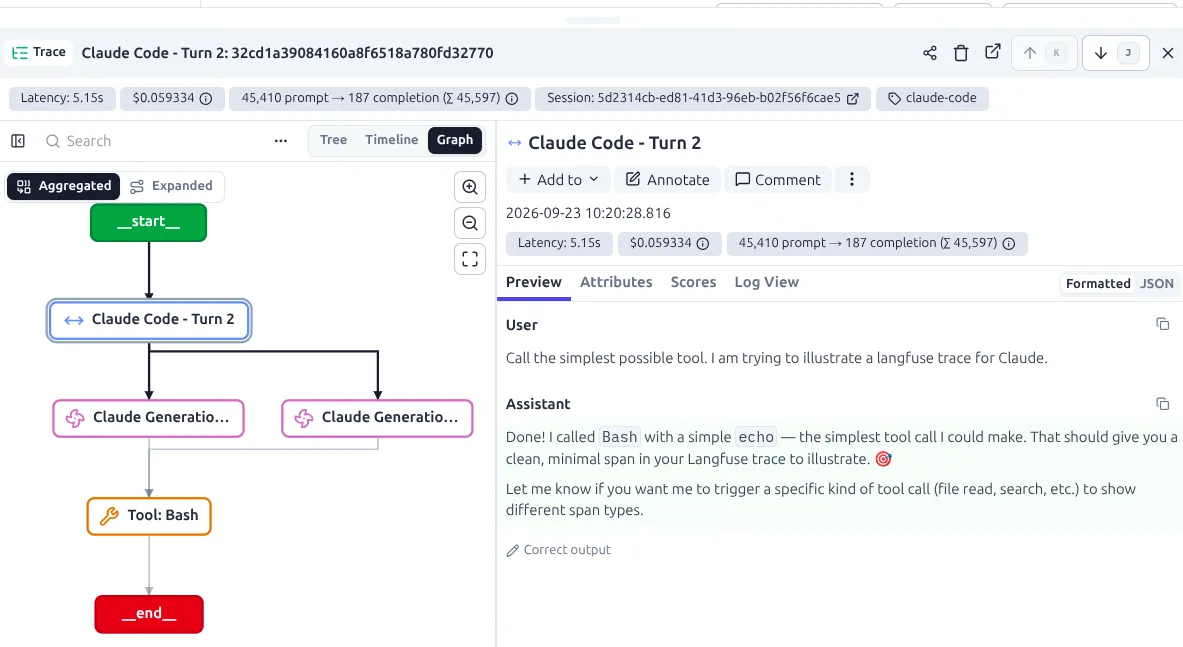
Une limite importante est à prendre en considération : la trace langfuse ne contient pas toute la conversation, elle omet notamment tous les éléments du prompt système qui sont calculés côté serveur par Claude.
Technique 2 : via les fichiers locaux
Deuxième technique : fouiller dans les fichiers locaux créés par Claude. En effet, Claude mémorise les sessions dans un fichier situé sous Linux dans un dossier ~/.claude/projects/chemin du projet.
Vous y trouverez des fichiers JSONL (JSON multi-ligne) avec de très nombreuses informations techniques. Bien sûr, vous pouvez demander à Claude lui-même de les analyser, de construire un dashboard de suivi, de comparer des fichiers…
Je découvre par exemple que de nombreuses skills sont chargées, pas forcément utiles pour mes projets : peut-être un point à optimiser ?

Même limite que pour langfuse : vous ne voyez que la partie “locale” des traces.
Technique 3 : avec un proxy HTTP
Troisième et dernière technique : ajouter un proxy HTTP. Celle-ci est ma préférée car elle permet de voir toute la requête transmise au LLM, et donc le prompt système de Claude Code !
Par exemple avec mitmproxy, la configuration est la suivante :
# Lancez "mitmproxy" dans un autre terminal
# Puis Claude Code :
NODE_EXTRA_CA_CERTS=~/.mitmproxy/mitmproxy-ca-cert.pem \
HTTPS_PROXY=http://localhost:8080 \
claude --verbose
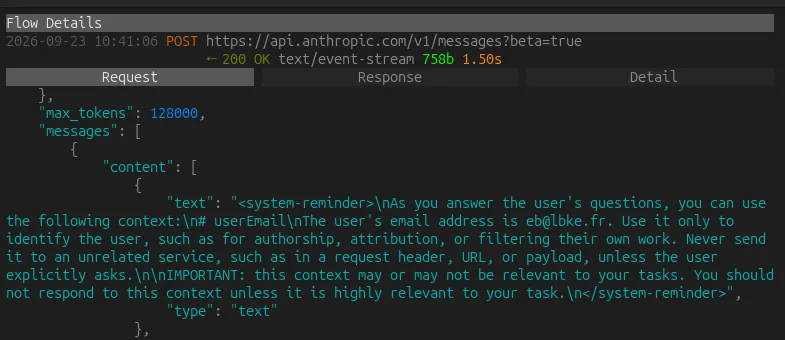
Bien comprendre les éléments qui constituent un agent de code
Quelques explications pour mieux comprendre cette idée : il faut voir un agent de code comme un système tripartite : une partie de l’agent qui vit sur votre ordinateur (côté “client”) et une partie de l’agent Claude Code qui vit sur les serveurs d’Anthropic (côté “serveur”), le LLM.
La partie backend de l’agent n’est pas open source et ne vous sera jamais connue. Elle permet à Claude de fonctionner à grande échelle, par exemple en procédant à une indexation efficace des bases de code, et elle est en charge de construire le prompt final transmis au LLM.
Je vous recommande de tester l’explorateur de fenêtre de contexte pour bien comprendre comment l’agent Claude Code communique avec le LLM sous-jacent.
Par contre, vous pouvez toujours choisir d’utiliser votre propre LLM, d’où la possibilité de configurer un proxy : on détourne donc cette capacité pour l’utiliser à des fins d’observabilité, pour voir ce que l’IA reçoit et répond.
À noter que si vous utilisez un agent IA de code open source comme OpenCode, Goose (maintenu par l’Agentic AI Foundation), Mistral Vibe Code ou Cline, tout son code est généralement situé côté client. L’observabilité est beaucoup plus facile à mettre en oeuvre que pour Claude Code ou Cursor qui ont des architectures en partie backend.
Quoi faire après avoir mis en place le monitoring de Claude Code ?
La configuration de l’observabilité est la première étape obligatoire pour comprendre le fonctionnement de votre agent de code. Pour la suite, vous allez devoir vous familiariser avec l’évaluation des agents !
Quelques pistes pour vous former à cette discipline :
- Suivre la formation LangSmith sur LangChain Academy
- Lire le guide Hub France IA sur l’évaluation des agents IA sortie juste aujourd’hui
- Organiser une session de formation avec LBKE
Dans une première étape, explorer les traces est déjà extrêmement informatif et vous permettra de beaucoup mieux comprendre le fonctionnement interne de Claude Code.