Une directrice commerciale enregistre la réunion mensuelle avec son équipe pour ne pas avoir à prendre de notes. Le lendemain, il lui faut un compte rendu qui retrace les décisions prises et les points restés en suspens. Les assistants de réunion intégrés aux outils de visioconférence savent produire ce document en quelques minutes, mais ils traitent l’enregistrement sur les serveurs de leur éditeur.
Or cet enregistrement contient des voix, des noms, des opinions et parfois des chiffres confidentiels. L’envoyer à un service en ligne suppose de vérifier où il est hébergé, ce que l’éditeur peut en faire et ce que prévoit le contrat. Faute de réponse claire, beaucoup d’entreprises interdisent ces outils, et le compte rendu continue d’être rédigé à la main, à raison d’une heure de travail pour une heure de réunion.
Il existe une autre voie : faire tourner les modèles d’IA directement sur l’ordinateur. Nous avons voulu vérifier si elle était accessible à quelqu’un qui n’écrit pas de code, avec un PC portable de bureau ordinaire et des logiciels gratuits « clés en main ».
Pourquoi traiter un enregistrement de réunion en local ?
La voix d’une personne identifiable est une donnée personnelle au sens du RGPD, au même titre que son nom. Confier un enregistrement à un prestataire en ligne revient à lui confier ces données, avec les obligations qui en découlent, notamment l’encadrement contractuel du sous-traitant et la vérification du lieu où les données sont traitées.
Lorsque le modèle d’IA s’exécute sur l’ordinateur de l’utilisateur, la question se pose différemment : de l’enregistrement jusqu’au compte rendu, aucun fichier ne quitte la machine. Dans ses précisions de juillet 2024 sur le déploiement des IA génératives, la CNIL recommande d’ailleurs de « privilégier le recours à des systèmes locaux, sécurisés et spécialisés ». Les enjeux plus larges de cette approche sont détaillés dans notre article consacré à l’auto-hébergement de l’IA générative en entreprise.
Le traitement local ne dispense pas de respecter les autres règles : les participants doivent être informés de l’enregistrement, et les fichiers doivent être conservés de façon sécurisée puis supprimés lorsqu’ils ne sont plus utiles. Il supprime en revanche la question du transfert à un tiers.
Le dispositif de test
Pour que le test soit représentatif, nous avons utilisé un ordinateur portable courant, équipé d’un processeur Intel Core i5 de 12ᵉ génération et de 16 Go de mémoire vive, sans configuration particulière.
Il fallait aussi un enregistrement librement réutilisable et proche d’une réunion réelle. Nous avons retenu les 30 premières minutes d’une table ronde sur le Digital Services Act organisée par Wikimédia France en 2022, publiée sous licence CC BY 3.0. Six personnes y prennent la parole, dont une animatrice qui présente chaque intervenant avec ses fonctions : un bon test pour les noms propres.
La chaîne de traitement comporte deux étapes, assurées par deux logiciels gratuits :
- la transcription, c’est-à-dire la conversion de la parole en texte, avec Buzz ;
- le résumé de cette transcription, avec Ollama.
Étape 1 : transcrire l’enregistrement avec Buzz
La transcription repose sur Whisper, un modèle de reconnaissance vocale publié en accès libre par OpenAI en 2022. Le mot « modèle » désigne ici le programme d’IA lui-même, entraîné à reconnaître la parole. Comme il est librement téléchargeable, il peut fonctionner sur n’importe quel ordinateur, sans connexion à OpenAI.
Whisper ne dispose pas d’interface : il faut un logiciel qui le pilote. Buzz joue ce rôle. Il s’agit d’une application gratuite et open source qui permet d’importer un fichier audio ou vidéo et d’en obtenir la transcription en quelques clics. Le fichier d’installation pour Windows se télécharge depuis la page du projet sur SourceForge, à laquelle renvoie la documentation officielle. L’application n’étant pas signée numériquement, Windows affiche un avertissement au premier lancement : il faut cliquer sur « Informations complémentaires », puis sur « Exécuter quand même ».
 Fenêtre de réglage de la transcription dans Buzz (moteur, taille du modèle, langue)
Au moment de lancer la transcription, quatre réglages comptent.
- Le moteur. Buzz en propose plusieurs. Il faut choisir « Faster Whisper », une version optimisée de Whisper qui fonctionne en local. L’option « OpenAI Whisper API », en revanche, envoie l’audio sur les serveurs d’OpenAI et annule tout l’intérêt de la démarche.
- La taille du modèle. Whisper existe en plusieurs tailles. Les plus grandes sont plus précises mais plus lentes ; nous en avons comparé deux (voir ci-dessous).
- La langue. Indiquer « French » plutôt que de laisser le logiciel la détecter.
- La tâche. Choisir « Transcribe » : l’autre option, « Translate », traduit le texte en anglais.
Au premier lancement, Buzz télécharge le modèle choisi. C’est la seule étape qui nécessite une connexion à Internet. Une fois la transcription terminée, il suffit de double-cliquer sur la ligne correspondante pour l’afficher, puis de l’exporter en texte brut (.txt). L’export au format .srt, qui associe chaque phrase à son horodatage, est utile pour retrouver un passage dans l’enregistrement au moment de la relecture.
Quelle taille de modèle choisir ?
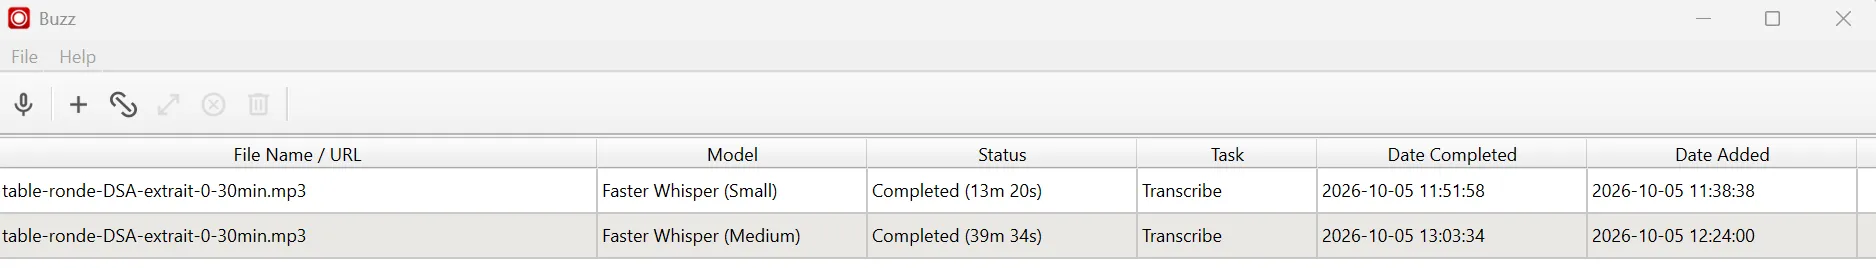
Nous avons transcrit le même extrait de 30 minutes avec deux tailles de modèle, « Small » et « Medium ».
| Modèle | Durée de transcription | Occupation du processeur |
|---|---|---|
| Small | environ 13 minutes | entre 22 % et 48 % |
| Medium | environ 39 minutes | même fourchette |
Avec le modèle Small, la transcription prend moins de la moitié de la durée de l’enregistrement. Le modèle Medium est trois fois plus lent et dépasse la durée de la réunion elle-même. Dans les deux cas, le processeur n’est jamais saturé : l’ordinateur reste utilisable pour d’autres tâches pendant le traitement.
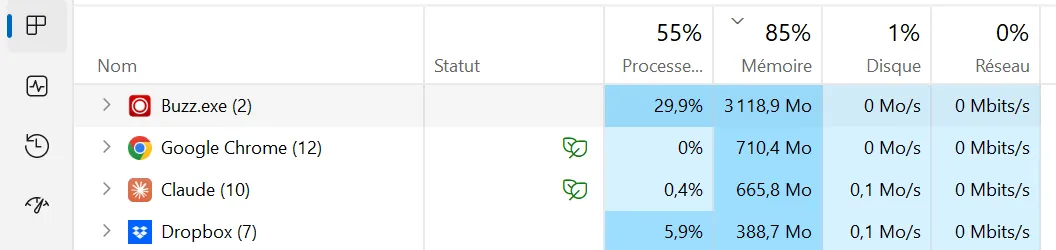 Occupation du processeur dans le Gestionnaire des tâches pendant la transcription
Sur le fond, les deux transcriptions sont de bonne qualité et rendent fidèlement le propos des intervenants. Les écarts portent surtout sur les noms propres et sur quelques mots. Le modèle Small écrit par exemple « Papa Nikolaou » pour Papanikolaou, « Sébastien Lovou » pour Sébastien Leroux, ou « nos vis » pour « novice ». Le modèle Medium corrige une partie de ces erreurs, mais il oublie toute ponctuation dans le premier paragraphe. Pour un compte rendu interne, le gain apporté par le modèle Medium ne justifie pas un temps de traitement triplé : le modèle Small est le choix raisonnable sur ce type de machine.
Étape 2 : résumer la transcription avec Ollama
La transcription obtenue compte environ 5 300 mots. Pour en tirer un compte rendu, il faut un modèle de langage, c’est-à-dire le type de modèle d’IA qui fait fonctionner les assistants conversationnels comme ChatGPT ou Claude. Les plus grands modèles de langage ne tiennent pas sur un ordinateur portable, mais il existe des versions réduites, publiées en accès libre, qui y fonctionnent correctement.
Ollama est un logiciel gratuit et open source qui permet de télécharger ces modèles et de les utiliser sur son ordinateur. Sous Windows, il s’installe avec un programme d’installation classique et propose une fenêtre de discussion semblable à celle des assistants en ligne. On y choisit un modèle dans une liste, on dépose le fichier de transcription et on formule sa demande.
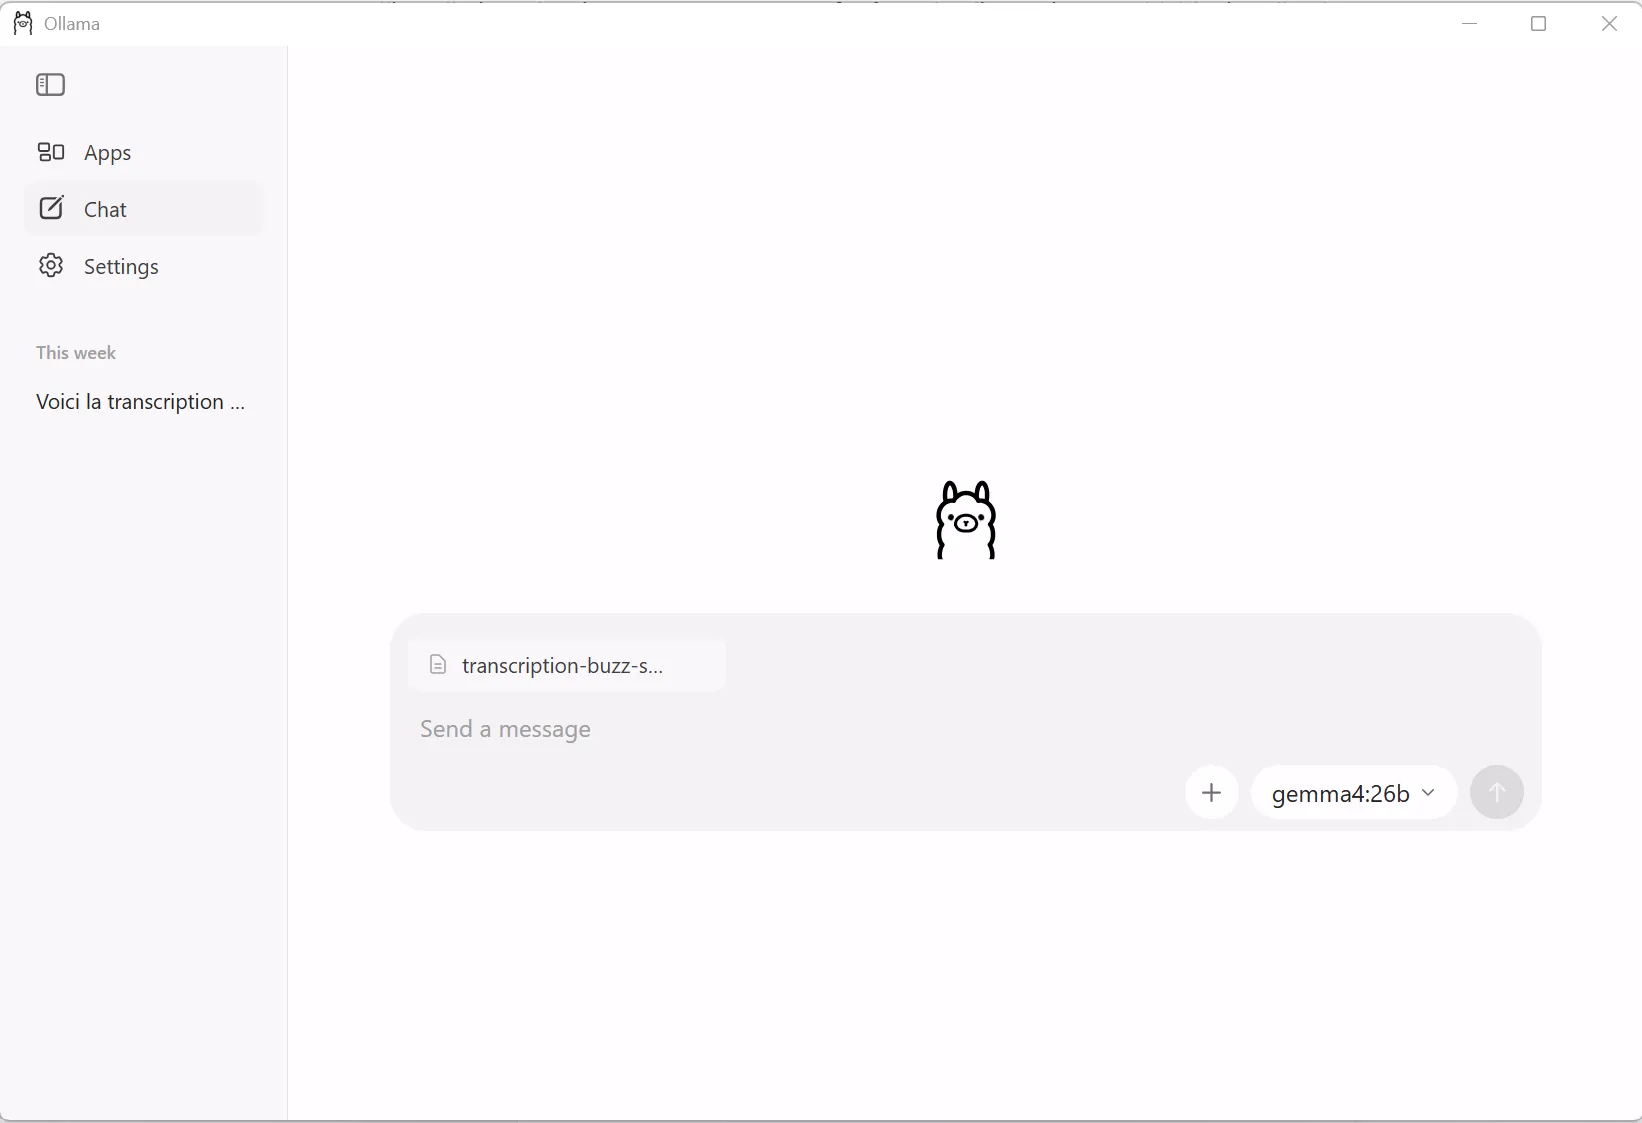 Fenêtre de discussion d’Ollama avec le fichier de transcription déposé
Deux points méritent d’être signalés au lecteur qui découvre l’outil.
Les tarifs affichés sur le site d’Ollama concernent ses modèles hébergés dans le cloud. L’utilisation d’un modèle sur son propre ordinateur est gratuite et illimitée, et ne nécessite pas de compte. Ollama propose en effet aussi des modèles « cloud », qui s’exécutent sur ses serveurs et se reconnaissent à la mention « cloud » dans leur nom : ils sont à écarter pour un usage confidentiel, pour la même raison que l’option « OpenAI Whisper API » de Buzz.
La fenêtre de contexte doit être agrandie. Un modèle de langage ne lit qu’une quantité limitée de texte à la fois, appelée fenêtre de contexte et mesurée en tokens, des fragments de mots. Par défaut, Ollama limite cette fenêtre à 4 096 tokens, alors que notre transcription en représente environ 7 000 à 8 000. Sans ajustement, le modèle ne lirait qu’une partie du texte, sans en avertir l’utilisateur. Il faut donc augmenter la longueur de contexte dans les réglages de l’application ; 16 000 tokens suffisent pour une réunion d’une demi-heure, au prix d’une consommation de mémoire plus élevée.
Nous avons utilisé le modèle Gemma 4 de Google, dans sa version gemma4:26b, et la consigne suivante :
Voici la transcription d’une table ronde. Rédige un compte rendu structuré : participants et fonctions, principaux points abordés, positions exprimées par chacun, questions restées ouvertes. Reste fidèle au texte et n’invente rien.
Le résumé a demandé 733 secondes, soit un peu plus de 12 minutes.
Que vaut le compte-rendu obtenu ?
Le document produit est clair et bien organisé. Il restitue correctement les échanges de la conférence, et corrige même certaines erreurs de transcription, en écrivant par exemple « MacronLeaks » là où Whisper avait compris « Macron-Lex ».
Ses défauts sont toutefois instructifs.
- Les erreurs de la transcription se retrouvent dans le résumé. Les noms mal orthographiés par Whisper (« Lovou », « Grosse » pour Grosset) sont repris tels quels : le modèle de langage n’a aucun moyen de deviner la bonne graphie.
- Le modèle ajoute ses propres erreurs. Il désigne l’animatrice, Joëlle Toledano, sous le prénom masculin « Joël », alors que la transcription la présente bien comme « professeure ».
- Il introduit une formule absente du texte, l’« effet boîte noire ». L’écart est mineur ici, mais il illustre un phénomène connu des modèles de langage : la production d’éléments plausibles qui ne figurent pas dans la source, souvent appelée « hallucination ».
Le compte rendu constitue donc une base de travail sérieuse, qui fait gagner l’essentiel du temps de rédaction, mais il doit être relu avant diffusion, en vérifiant en priorité l’identité des personnes et les propos qui leur sont attribués.
Comment fiabiliser les noms propres ?
Les erreurs sur les noms propres sont le défaut le plus visible de cette chaîne. Deux réglages permettent de les réduire, l’un au moment du résumé, l’autre dès la transcription.
Le premier consiste à fournir la liste des participants à Ollama dans la consigne de résumé, avec l’orthographe exacte de leur nom et leur fonction. Le modèle de langage peut alors rapprocher « Lovou » de « Leroux » et corriger le compte rendu. Cette solution suppose seulement de préparer la liste avant de lancer le résumé.
Le second agit à la source. Whisper accepte une consigne initiale (initial prompt), un court texte qui l’oriente sur le vocabulaire attendu. Le guide publié par OpenAI indique que ce procédé améliore l’orthographe des noms propres et des termes peu courants. Dans Buzz, ce champ se trouve dans les options avancées de la fenêtre de transcription. Il suffit d’y saisir une phrase qui présente la réunion et nomme ses participants, par exemple : « Table ronde sur le Digital Services Act animée par Joëlle Toledano, avec Phil Bradley-Schmieg, Marie Grosset, Sébastien Leroux, Benoît Loutrel et Hector de Rivoire. » Le même guide précise que Whisper ne tient compte que de la fin d’une consigne trop longue : mieux vaut donc s’en tenir à quelques lignes.
Les deux réglages se complètent : une transcription plus juste produit un résumé plus juste, et la consigne d’Ollama rattrape les erreurs qui subsistent.
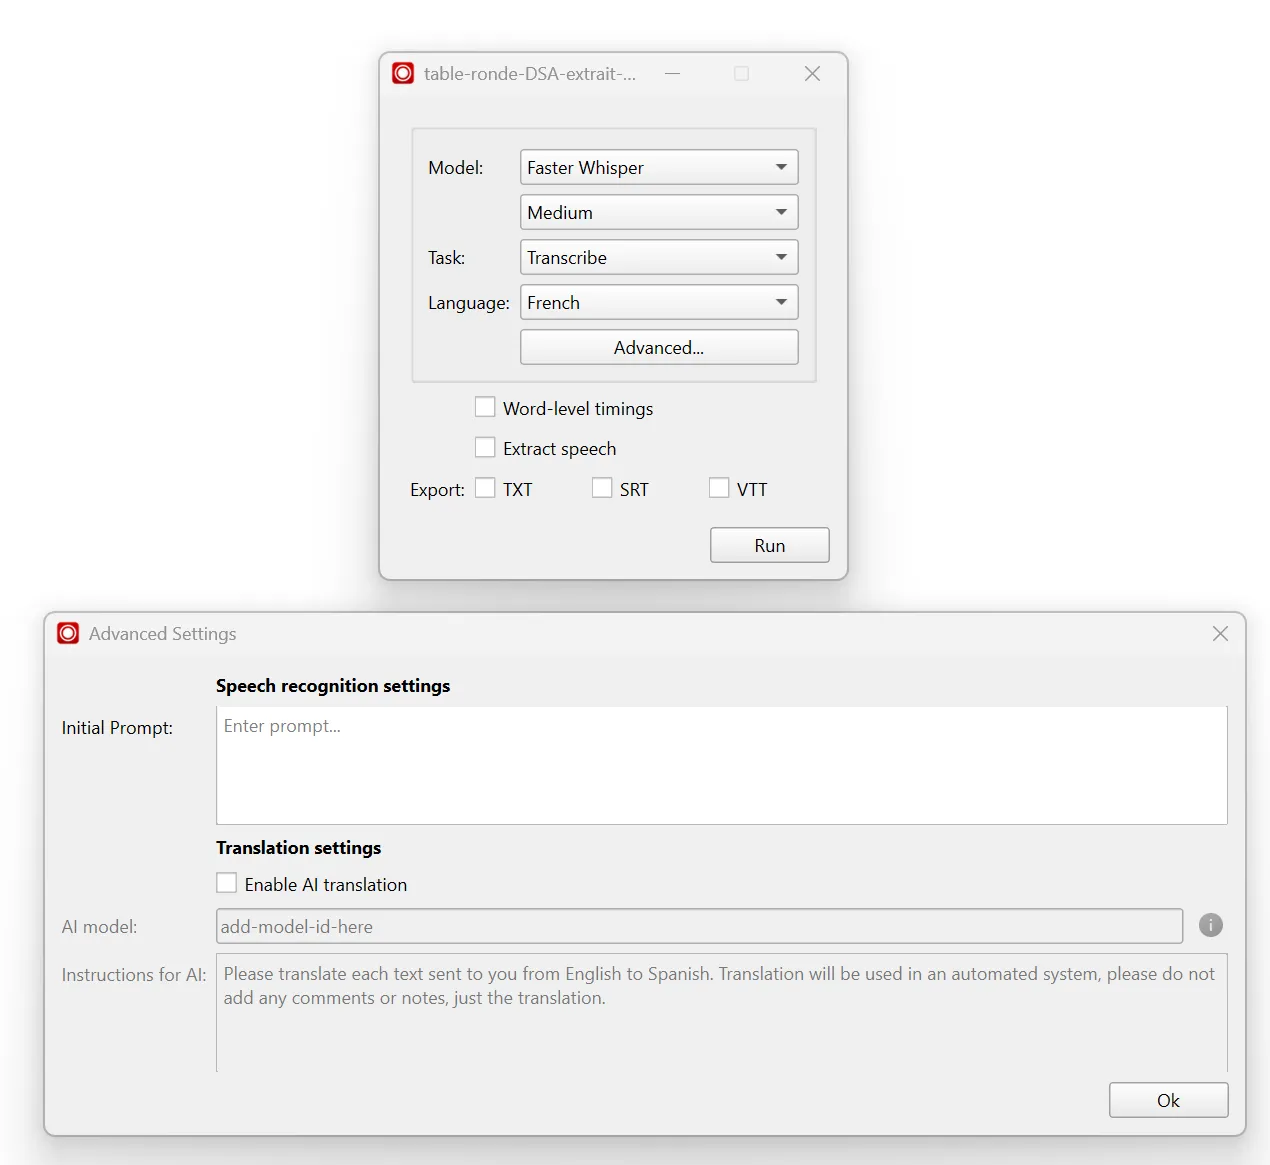 Options avancées de Buzz avec le champ “Initial prompt”
Le coût de ce processus réalisé entièrement en local
Sur notre ordinateur de test, la chaîne complète (transcription avec le modèle Small, puis résumé) a demandé environ 25 minutes pour 30 minutes de réunion, sans qu’aucun fichier ne quitte la machine et sans aucun coût. Un service en ligne serait plus rapide, et produirait probablement un résumé de meilleure qualité grâce à des modèles plus grands. L’intérêt de la démarche tient donc à la confidentialité qu’elle garantit, au prix d’un traitement plus lent.
Deux limites doivent aussi être connues :
- La première est l’absence d’identification des locuteurs : la transcription produite par Buzz est un texte continu, qui ne précise pas qui parle. Le modèle de langage a pu attribuer les propos aux bons intervenants parce que l’animatrice les présentait nommément, ce qui ne sera pas le cas dans toutes les réunions.
- La seconde tient à la relecture humaine, qui reste indispensable et prend un temps qu’il faut intégrer au calcul.
Transcrire une réunion avec l’IA tout en préservant la confidentialité des données : une activité réalisable en local, sur un ordinateur classique
Transcrire et résumer une réunion sans recourir au cloud est aujourd’hui à la portée de toute personne capable d’installer un logiciel, avec du matériel de bureau courant. Le résultat n’atteint pas la qualité des meilleurs services en ligne, mais il fournit une base de compte rendu exploitable, pour un coût nul et une maîtrise complète des données.
Cette chaîne peut encore être améliorée. L’identification automatique des locuteurs, que les spécialistes appellent diarisation, permettrait d’obtenir une transcription où chaque intervention est attribuée. La pseudonymisation de cette transcription, qui consiste à remplacer les noms par des identifiants, ouvrirait ensuite la voie à des analyses du contenu plus poussées avec des outils en ligne (intégration du compte-rendu anonymisé dans un projet Claude Cowork, par exemple).