Selon les études, la part des emplois considérés comme exposés à l’intelligence artificielle générative varie de 5 % à 33 %. Cet écart, que documente la synthèse que l’Unédic a consacrée aux travaux économiques sur le sujet (Baquero, 2025), n’a rien d’anecdotique : selon l’étude consultée, l’ampleur estimée du phénomène peut considérablement varier.
Cet écart ne provient pas d’un désaccord sur les faits, mais des choix méthodologiques que chaque étude opère en amont, souvent de façon peu visible pour son lecteur : la manière de découper un métier en tâches élémentaires et le critère retenu pour juger qu’une tâche est automatisable. Ces choix, présentés comme des détails techniques réservés aux économistes, déterminent pourtant l’essentiel du résultat affiché en conclusion.
Or ces résultats circulent largement au-delà du cercle académique : ils orientent des décisions concrètes, par exemple en matière de recrutement ou de formation, alors que peu de leurs lecteurs savent comment ils ont été construits. Entrer dans cette boîte noire méthodologique permet de combler cet écart : comprendre comment un chiffre est construit permet d’apprécier ce qu’il mesure réellement, et ce qu’il laisse de côté.
L’approche par tâches, une méthode pour évaluer l’impact de l’IA sur l’emploi
L’approche par tâches est la plus usitée par les économistes pour mesurer l’impact de l’IA sur l’emploi. Cette approche, dont l’une des références fondatrices est l’article d’Autor, Levy et Murnane (2003), a pour intérêt de considérer que le changement technologique redistribue le partage des tâches entre le capital (en l’espèce, l’IA) et le travail humain, et que l’impact de l’IA sur un métier dépend de la proportion de tâches que celle-ci finira par automatiser (Verdugo, 2025).
Le principe consiste ainsi à décomposer chaque métier en tâches élémentaires, puis à évaluer le potentiel d’automatisation de chacune d’elles. Le score global attribué à un métier résulte ensuite de l’agrégation des scores obtenus au niveau de chaque tâche qui le compose (Arquié et al., 2026).
Pour mettre en œuvre cette décomposition, les chercheurs s’appuient le plus souvent sur la base de données O*NET, créée par le ministère du Travail des États-Unis. Cette base référence plus de 900 professions et propose, pour chacune, une liste détaillée de tâches la composant. Une fois cette classification établie, il reste à évaluer le potentiel d’automatisation de chaque tâche, ce qui peut se faire de trois manières : en sollicitant l’avis d’experts du domaine sur les possibilités offertes par l’IA au moment de l’étude, en posant la même question à un grand modèle de langage, ou en analysant les textes de brevets déposés dans le domaine de l’IA. En effet, comme l’indique Verdugo (2025) l’analyse des brevets permet d’objectiver les capacités de l’IA à prendre en charge telle ou telle tâche, puisque les dépôts de brevets mentionnent fréquemment les tâches que l’innovation est censée automatiser, ainsi que les secteurs d’activité visés.
Quels métiers sont menacés par l’IA, et dans quelle proportion ?
D’après la note de la Direction générale du Trésor publiée en juin 2026 (Chopard et al., 2026), la littérature empirique ne permet pas, à ce stade, d’identifier un effet clair de l’IA sur le niveau agrégé d’emploi, c’est-à-dire considération faite des créations et des destructions d’emploi liées à l’IA. Les travaux antérieurs affichaient des résultats très dispersés et portaient sur des formes d’IA aujourd’hui dépassées. Deux explications sont avancées pour expliquer cette difficulté de mesure : la diffusion de l’IA dans les entreprises reste partielle à ce jour (pour plus de précisions, vous pouvez lire notre article sur l’état des lieux de l’IA en entreprise en 2026), et les destructions d’emplois liées à l’automatisation tendent à être compensées par les créations d’emplois issues des gains de productivité que l’IA génère par ailleurs.
Plusieurs études cherchent néanmoins à anticiper les métiers et les secteurs d’activité susceptibles d’être les plus impactés par l’IA. La note de la Direction générale du Trésor apporte une précision utile sur la nature des tâches concernées : les tâches cognitives seraient les plus exposées à l’IA générative, les tâches physiques les moins concernées, les tâches relationnelles se plaçant à mi-chemin entre les deux. Mais, comme le rappelle également cette étude, « le niveau d’exposition à l’IA ne suffit pas à déterminer l’effet final sur l’emploi ». Il convient en outre de séparer deux cas de figure au sein de ces tâches exposées : celui où l’IA renforce le travail humain sans s’y substituer (cas de la complémentarité), et celui où elle peut effectivement le remplacer (cas de la substitution). Ces deux cas de figure, complémentarité ou substitution, produisent des impacts très différenciés sur l’emploi.
Si en cas de substituabilité de l’IA avec un métier, l’IA pourrait effectivement avoir un effet négatif sur l’emploi, en cas de complémentarité de l’IA avec un métier, les tâches à faibles valeur ajoutée sont prises en charge par l’IA, le travailleur pouvant alors se focaliser sur les tâches à plus forte valeur ajoutée. Ainsi, les gains de productivité générés peuvent stimuler l’emploi par deux mécanismes :
- D’une part, la hausse de la productivité des salariés diminue leur coût relatif pour leur employeur (dans l’hypothèse où les salaires restent constants, les salariés produisent en effet plus pour un même coût employeur), incitant potentiellement l’entreprise à embaucher plus
- D’autre part, la hausse de la productivité induisent une augmentation des quantités offertes et une diminution des prix (en fonction, bien entendu, de l’élasticité prix de la demande, qui varie selon le type de bien/service produit par le métier en question) stimulant la demande, et favorisant in fine l’emploi d’un plus grand nombre de salariés pour répondre à cette nouvelle demande.
Cela dit, la proportion et la nature des emplois affectés par l’IA ne fait pas consensus au sein de la littérature, comme le confirme une note d’analyse réalisée par l’Unédic (Baquero, 2025). Le graphique de synthèse de la Direction Générale du Trésor dresse ci-dessous un panorama des résultats des études existantes.
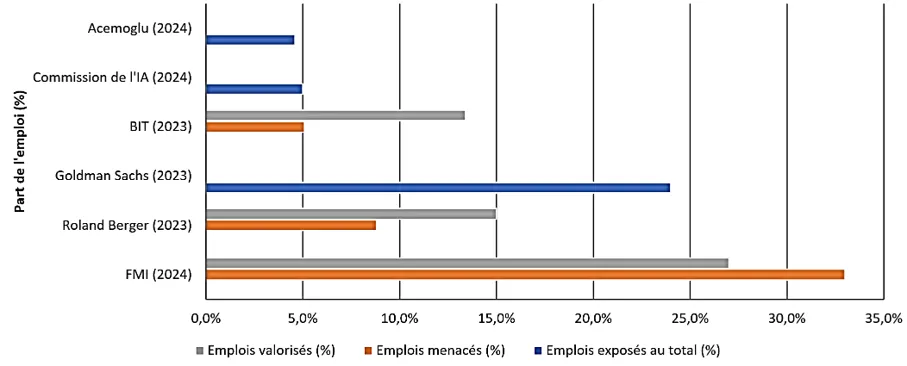
Graphique : Estimations d’emplois exposés, menacés et valorisés par l’IA générative (en % de l’emploi total)
Lecture : est qualifié de menacé un emploi dont une large part des tâches pourrait être automatisée, sans que cela présage sa disparition (substitution). Est qualifié de valorisé un emploi dont seule une partie des tâches serait reprise par l’IA, le travailleur pouvant alors se consacrer à de nouvelles missions à plus forte valeur ajoutée (complémentarité).
Source : graphique construit d’après Baquero, L. (2025, janvier). Emploi et IA générative : panorama des travaux économiques existants. Unédic.
Comme le montre le graphique, la proportion d’emplois exposés à l’IA s’établirait dans une fourchette allant de 5 à 33 %. Ces études reposent pourtant toutes sur la même approche par tâches. Une partie de l’écart tient sans doute aux échantillons, différents d’une étude à l’autre. Mais il peut aussi provenir d’un choix interne à la méthode elle-même : chaque étude évalue à sa manière le potentiel d’automatisation d’une tâche, par des avis d’experts, par un grand modèle de langage ou par l’analyse de brevets, et ces façons de procéder peuvent ne pas s’accorder sur le même score pour une même tâche.
Les limites de l’approche par tâches
L’approche par tâches présente néanmoins plusieurs limites. Arquié et al. (2026) relèvent d’abord que les tâches recensées dans O*NET manquent de granularité : elles regroupent souvent des actions complexes et hétérogènes sous une même dénomination, ce qui rend leur évaluation moins précise qu’il n’y paraît. Les mêmes auteurs soulignent ensuite que l’évaluation du potentiel d’automatisation, qu’elle soit produite par des experts ou par un LLM, reste difficile à auditer et repose sur des critères peu objectivables : l’appréciation du caractère automatisable d’une tâche peut varier d’un expert à l’autre, tout comme les réponses d’un LLM peuvent varier selon la formulation du prompt utilisé.
Un rapport récent de l’OCDE (2026) pointe une autre limite, identique à celle formulée par Verdugo (2025) : la description des métiers par tâches néglige le fait que deux personnes exerçant le même métier ne réalisent pas nécessairement les mêmes tâches dans les mêmes proportions. À cela s’ajoute le constat que les études mobilisant l’approche par tâches ne sont pas aisément actualisables, ce qui est problématique puisque les technologies d’IA évoluent rapidement, comme nous venons de le voir : une étude publiée peut donc se retrouver rapidement en décalage avec les capacités réelles de l’IA au moment où elle est lue.
Autre limite, cette fois lorsqu’on cherche à évaluer l’évolution des salaires avant et après l’introduction de l’IA dans un métier, l’avant et l’après ne décrivent en réalité pas le même travail (Autor, 2013) . La comparaison porte alors sur deux bouquets de tâches différents, puisque la composition même du poste a changé, et non sur la rémunération d’une tâche identique réalisée avec puis sans l’aide de l’IA.
L’approche par tâches, un outil solide aux limites bien réelles
L’approche par tâches reste la méthode de référence pour évaluer l’impact de l’IA sur l’emploi : décomposition d’un métier en tâches élémentaires, le plus souvent à partir de la base O*NET, puis évaluation du potentiel d’automatisation de chacune. Pour un métier exposé, il est toutefois également nécessaire d’identifier si l’IA tend plutôt à être complémentaire de ce métier, ou à lui être substituable ; si la substitution menace un poste, la complémentarité peut au contraire le renforcer.
Les estimations de l’impact de l’IA sur l’emploi s’inscrivent dans une fourchette assez large, allant de 5 % à 33 % des emplois selon l’étude consultée : selon la façon dont une étude découpe les tâches et selon la source mobilisée pour juger de leur automatisation, les résultats obtenus peuvent varier fortement, sans que les chercheurs se contredisent nécessairement sur les faits.
L’approche par tâche comporte cependant des limites qui tempèrent sa portée. La décomposition proposée par O*NET manque parfois de granularité, et le score d’automatisation obtenu, qu’il provienne d’un avis d’expert ou d’un LLM, reste difficile à auditer. Le métier lui-même est un objet mouvant : deux personnes qui l’exercent n’en réalisent pas nécessairement les mêmes tâches, et sa composition évolue avec l’introduction de l’IA, ce qui complique toute comparaison entre un avant et un après recouvrant, en réalité, deux emplois différents. Enfin, les technologies évoluent plus vite que la recherche ne peut les documenter : une étude publiée risque d’être déjà datée au moment où elle est lue.
Connaître ces choix méthodologiques permet de lire les chiffres qui circulent sur l’IA et l’emploi pour ce qu’ils sont : des estimations construites à partir d’hypothèses précises, et non des mesures neutres d’un phénomène déjà stabilisé.
Bibliographie
-
Autor, D. H., Levy, F., & Murnane, R. J. (2003). The skill content of recent technological change: An empirical exploration. The Quarterly journal of economics, 118(4), 1279-1333.
-
Verdugo, G. (2025). L’IA et l’emploi. Presses de Sciences Po.
-
Chopard, M., Cotet, E., Gantois, T., Villani, E. (2026, juin). L’intelligence artificielle, quels effets sur l’emploi ? Trésor-Éco, n°391, Direction générale du Trésor. Lire la publication en ligne.
-
Baquero, L. (2025, janvier). Emploi et IA générative : panorama des travaux économiques existants. Unédic. Lire la publication en ligne.
-
Autor, D. H. (2013). The “task approach” to labor markets: an overview. Journal for Labour Market Research, 46(3), 185-199. Lire la publication en ligne.